研究提出复用已渲染RGB-D图像的局部视角合成方法
复用已渲染RGB-D图像的局部视角合成方法
(映维网Nweon 2026年10月26日)在交互式场景探索中,camera小幅移动时,新目标视角往往与已经渲染的图像有大量重叠。但传统3DGS仍会为每个目标视角重新渲染。针对这个问题,有研究人员提出了一种逐场景框架:不再重复渲染邻近视角,而是复用已有的RGB-D图像,通过相对位姿引导的几何变形迁移源内容,再用轻量多尺度网络预测RGB残差,校正变形伪影并推断缺失外观。
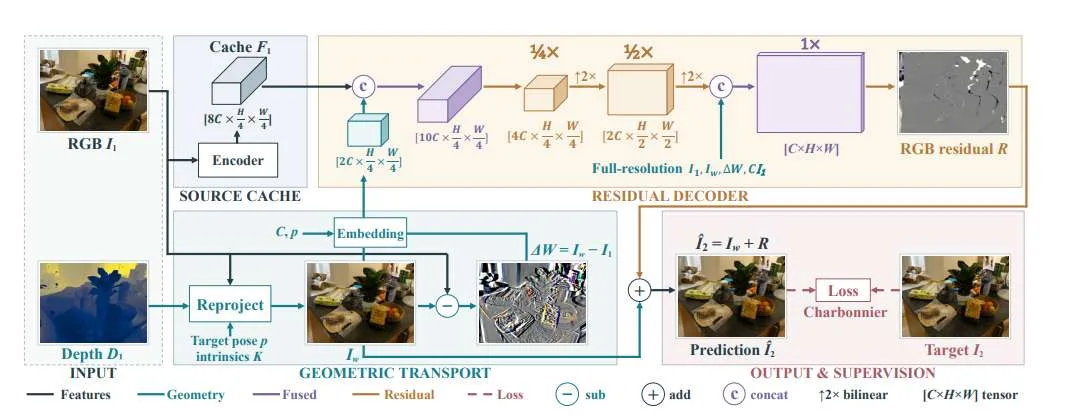
团队将问题拆成两部分:几何迁移和残差外观校正。几何变形利用深度、camera内参和相对位姿,把源图像像素重投影到目标视角,并对源颜色进行泼溅、按深度过滤和覆盖率加权填充;在没有投影支持时返回源图像。随后,编码器提取源图像特征,解码器结合变形图像、RGB差值、覆盖率和相对位姿等信息,在四分之一分辨率处拼接特征,逐步细化到全分辨率,并由线性RGB头输出残差。残差加到变形图像上,得到目标视角预测。
训练方面,研究人员对每个静态场景单独训练编码器和解码器,使用Charbonnier损失;RGB头零初始化,使初始预测等于几何变形结果。推理时,源特征和预处理几何按源缓存一次,每个目标仍需执行重投影、残差解码和合成。
......(全文 761 字,剩余 328 字)