研究提出FoV-BSM-Net:可穿戴麦克风阵列双耳再现的自适应视场方法
可穿戴麦克风阵列双耳再现的自适应视场方法
(映维网Nweon 2026年10月05日)一支研究人员提出了一种全新的双耳信号匹配方法FoV-BSM-Net。相关方案利用卷积循环神经网络从麦克风信号中直接学习视场参数,避免了显式的声源定位,并在仿真和听音实验中优于传统方法。
虚拟现实、增强现实和高保真远程会议等应用对双耳再现的需求日益增长。双耳信号匹配(BSM)是一种常用的双耳再现方法,它在扩散场假设下能产生高质量的双耳信号,但在高直混比(DRR)条件下性能会下降。先前的改进方案引入了视场加权,但要么使用固定孔径,要么依赖显式声源定位,前者空间覆盖粗糙,后者受定位估计精度限制。
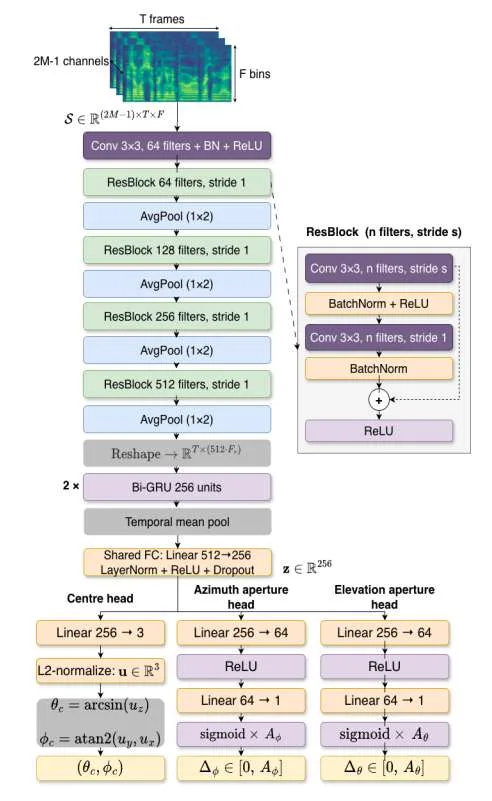
FoV-BSM-Net将FoV估计表述为信号相关的回归问题。整个流程分三步:首先,麦克风信号经短时傅里叶变换并组合为SALSA-Lite风格的空间表示;其次,卷积循环神经网络将该表示映射为四个FoV参数——中心仰角、中心方位角、仰角孔径和方位角孔径;最后,这些参数定义一个可微软加权矩阵,集成到BSM滤波器中,实现端到端训练。
网络采用ResNet风格卷积骨干、两层双向GRU和三个回归头,分别预测FoV中心和两个孔径。训练使用复合损失,包括声源方向损失、双耳声级差/双耳时间差损失和归一化均方误差损失。
研究在仿真房间中生成数据集,使用Aria-reduced五麦克风阵列、KU100人工头HRTF和LibriSpeech语音,包含12,000个单声源混响场景,覆盖三种房间尺寸和0.30、0.61、1.40秒的混响时间。对比方法为传统BSM、固定FoV-BSM(60°×20°)和FoV-BSM-Net。
全频带双耳NMSE结果显示,FoV-BSM-Net相对BSM平均改进1.0 dB,在高DRR条件下改进1.7 dB;固定FoV-BSM的改进分别为0.5 dB和0.8 dB。在双耳线索方面,FoV-BSM-Net的ICLD误差为3.1 dB,IPD误差为9.1°,均低于BSM(8.9 dB、43.2°)和固定FoV-BSM(5.1 dB、16.9°)。
听音实验采用MUSHRA方法,12名听力正常受试者参与,评估两个场景。在低DRR(4.4 dB)场景中,FoV-BSM-Net与参考信号在统计上无法区分;在高DRR(12.1 dB)场景中,三种方法均与参考有显著差异,但FoV-BSM-Net评分显著高于固定FoV-BSM和BSM。
相关论文:Neural Field-of-View for Binaural Signal Matching with Wearable Microphone Arrays
FoV-BSM-Net避免了显式声源估计,同时保留了信号相关BSM的性能优势,在低DRR下与参考匹配,在高DRR下保持最高感知质量。不过,当前评估限于仿真的单声源场景,未来工作将扩展到真实录音和多声源条件。