研究提出EyeMakeYou,用多条件扩散模型合成高频眼动信号
用多条件扩散模型合成高频眼动信号
(映维网Nweon 2026年09月14日)眼动生物识别系统需要大量高质量、高采样率的眼动数据,但这类数据采集成本高、规模有限。针对这个问题,有研究人员提出一种名为EyeMakeYou的多条件去噪扩散模型,根据用户身份、任务背景和主观状态生成受试者特定的高频注视速度信号。
眼动生物识别是近年来受到关注的行为生物识别方式,可用于用户认证,尤其在虚拟现实和增强现实系统中,注视动态包含受试者特定特征。但高采样率眼动信号,例如250至1000赫兹的信号,能够表示扫视、微扫视和平滑追踪等快速事件,同时也可能包含身份相关信息。收集这类数据需要专业设备、参与者时间和人力,许多大规模数据集还属于专有数据,因此合成受试者特定注视数据成为增强有限真实数据的一种思路。
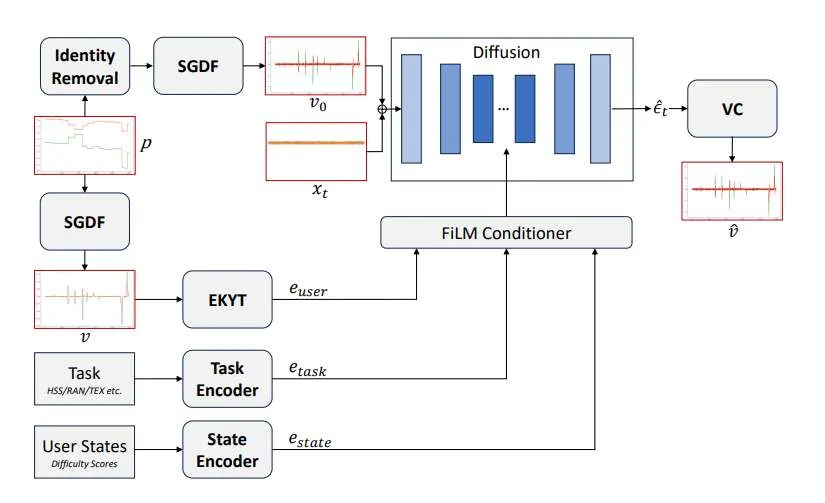
现有生成方法要么合成通用注视行为,要么主要按身份个性化信号,没有联合表示用户的任务和主观状态。为此,研究团队提出EyeMakeYou,生成5秒、1000赫兹的双变量注视速度序列。模型以去除身份信息的低频参考轨迹为基础,并同时以三类条件控制生成过程:用户身份嵌入、任务嵌入,以及自我报告的整体难度、精神疲劳和眼睛疲劳评分。这些主观评分采用1至7的Likert量表。
在方法上,研究团队将真实注视位置信号下采样至20赫兹,再线性插值回1000赫兹,得到低频参考轨迹。用户身份特征由预训练的Eye Know You Too编码器从原始速度信号中提取,得到128维身份表示;任务背景由128维任务嵌入表示;三个主观状态评分经两层多层感知机编码为32维状态表示。模型使用50个扩散步骤和30层膨胀残差去噪器。训练目标除扩散噪声预测外,还包括身份保持损失、多分辨率频谱损失、漂移一致性损失和事件加权局部平滑损失。
实验使用公开的GazeBase数据集。该数据集由Eyelink 1000眼动仪采集,包含单眼左眼运动数据,采样率为1000赫兹;数据集在37个月内进行九轮,涉及322名志愿者,产生12334条眼动追踪记录,包含注视、水平扫视、随机斜向扫视、阅读、电影视频自由观看和注视驱动游戏等七类任务。论文称,训练集包含263名参与者的记录,测试集包含第6轮出现的59名受试者,训练集和测试集之间没有用户重叠。
在空间精度方面,在中位用户和中位误差水平下,EyeMakeYou在水平扫视任务中误差为3.60 dva,在随机斜向扫视任务中为2.81 dva,低于SP-EyeGAN、VAE基线和DiffEyeSyn。在更严格的高误差条件下,EyeMakeYou在水平扫视任务中误差为31.15 dva,接近真实信号的30.85 dva,并优于DiffEyeSyn的38.61 dva、SP-EyeGAN的52.73 dva和VAE的50.81 dva。在随机斜向扫视任务中,EyeMakeYou误差为28.77 dva,优于SP-EyeGAN的47.07 dva和VAE的34.75 dva,但DiffEyeSyn为26.77 dva,略低于EyeMakeYou。
在空间精确度方面,所有合成方法在中位条件下均得到0.01度RMS。在高误差条件下,EyeMakeYou在水平扫视任务中为0.21度RMS,低于DiffEyeSyn的0.35、SP-EyeGAN的0.37和VAE的0.23;在随机斜向扫视任务中为0.29度RMS,与DiffEyeSyn相同。论文同时指出,所有合成方法的高百分位离散度都低于真实信号,真实信号在水平扫视和随机斜向扫视任务中分别为0.86和1.14度RMS。这可能意味着生成模型平滑了部分高变异性行为,因此合成数据更适合补充而非完全替代真实记录。
当然,研究存在一定的局限性,评估使用GazeBase中5秒片段和单一眼动仪,测试集包含未见过的用户,但没有验证跨设备、跨实验室、更长交互会话或自然视觉环境的泛化能力;另外,EyeMakeYou属于条件合成方法,需要从真实记录导出的低频参考和身份嵌入,目标用途是条件增强或用户特定注视的高频重建,而不是仅凭身份、任务和状态标签进行无约束生成;同时,主观状态关系的保留仍不完整。
团队认为,EyeMakeYou的最强用例是作为受试者特定合成样本的来源,用于增强基于注视的生物识别和交互系统数据集,特别是在真实数据有限时。未来工作将评估更多眼动仪、更长记录和更自然任务,报告完整的生物识别认证与识别性能,并对身份、任务、状态、频谱、漂移和平滑等组件进行消融研究。