杭电研究人员提出ML-IST:用机器学习加速内球树叶球构建
用机器学习加速内球树叶球构建
(映维网Nweon 2026年11月02日)碰撞检测是虚拟现实等应用中的基础环节。对于带孔洞、凹槽和薄壁结构的复杂非凸物体,如何既快速又准确地描述其内部占据空间,一直是难点。杭州电子科技大学团队提出一种名为ML-IST的方法,将传统内球树的叶球生成改为机器学习预测,在测试中降低了叶球构建时间,并在物理引擎基准中取得较高帧率。
内球树(IST)通过在物体内部放置互不重叠的内切球并组织成层次结构,支持邻近查询和穿透查询。但传统叶球生成依赖符号距离场上的贪心迭代:反复寻找最大允许内球,再更新剩余可行区域。这一过程本质串行,难以充分利用GPU并行能力,构建时间随体素分辨率、几何复杂度和目标球数增加而上升。
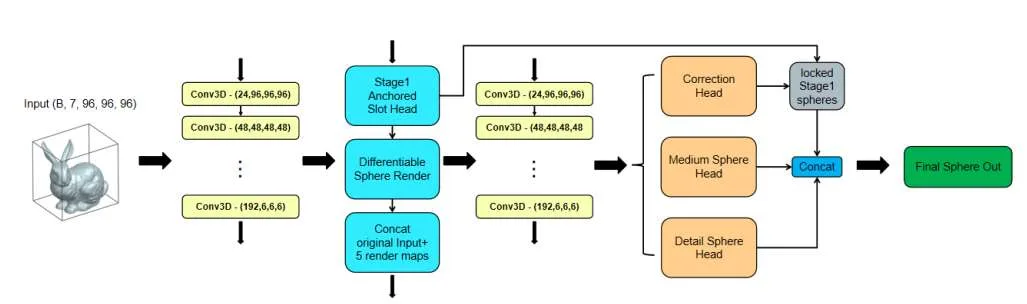
ML-IST的思路是把叶球生成表述为“固定容量球集预测”。据介绍,方法先将三维模型重采样为七通道体素输入,包括内部掩码、内部距离场、归一化符号距离场、边界通道和三维坐标通道;随后由多阶段网络一次性预测候选球的球心、半径和物体性得分。网络先以大尺寸基础球建立主要内部覆盖,再用可微渲染器把基础球覆盖转换为体素级反馈,由第二个编码器据此修正基础球并预测中等、细节尺度的残余球,以填补空隙。推理阶段再用局部距离场限制半径,经几何投影保证球位于物体内部。团队强调,这一方法只针对传统IST中开销最大的叶球生成阶段,并不替换完整IST框架,生成的球仍可组织为传统层次结构供现有碰撞查询使用。
研究人员使用3780个三维模型进行实验,其中3600个用于训练、180个留作测试。在目标叶球数64、128、256、512的设置下,每个设置单独训练模型。计时比较中,ML-IST使用单块RTX 4090 GPU推理,传统GT-IST使用Intel Xeon Platinum 8368Q单核并启用SIMD向量化。报告在100个留出测试模型上取平均,ML-IST的平均叶球生成时间减少到传统方法的1/2.0至1/2.6,且对目标球数增加不如传统贪心方法敏感;当四块RTX 4090并发处理四个模型时,每模型成本摊销至约3.0毫秒。定性结果中,手形、狗形和仓鼠形等非凸模型的预测球分布跟随模型轮廓,大球覆盖手掌、躯干等厚实区域,小球沿手指、四肢、耳朵等细长特征延伸。
除几何和计时实验外,团队同时评估了动态可用性。在自由落体碰撞场景中,ML-IST代理与可见网格共享刚体变换,能够产生完整的接触和姿态变化响应;每步碰撞相关计算时间与传统IST处于同一数量级,未出现数量级开销,但两者随时间交替领先,并非始终一方更快。线速度曲线显示,ML-IST代理经历了自由落体、撞击和阻尼振荡,最终进入静止状态。
在系统级评估中,作者将ML-IST集成到Jolt Physics和Bullet引擎,并在alpha-puzzle基准中与传统IST、Bullet的GImpact三角网格结构以及凸包加凸分解比较。在RTX 4090和Xeon 8368Q平台上,ML-IST达到55.89 FPS,GT-IST为31.33 FPS,GImpact为26.79 FPS,凸包加凸分解为2.57 FPS。研究人员称,隔离推理测试中生成一个IST模型约需12毫秒;集成引擎后还有GPU-CPU传输和同步成本,完整基准下ML-IST约以55 Hz运行,接近实时仿真常用的50至60 Hz范围。
相关论文:Fast Construction of Inner Sphere Trees Using Machine Learning
当然,评估范围限于叶球生成,后续层次构建和碰撞查询时间未纳入生成时间比较;几何精度仍受体素离散化和插值误差影响。未来工作包括在更多模型拓扑和体素分辨率上评估、分析计时方差和GPU-CPU传输策略,以及面向碰撞检测、物理仿真和交互式虚拟环境的运行时预处理。