KAD-Net:用运动学感知解耦学习提升单深度图像3D手部姿态估计
用运动学感知解耦学习提升单深度图像3D手部姿态估计
(映维网Nweon 2026年09月21日)一项关于单深度图像3D手部姿态估计的研究提出了一种名为KAD-Net的网络。通过手指拓扑约束模块和任务解耦的层次化多任务框架,这一方案旨在应对手部运动学复杂、自遮挡严重,以及2D关节定位与深度估计相互干扰等问题。
3D手部姿态估计可应用于虚拟现实等领域。但从单张深度图像准确推断3D手部姿态仍然困难,原因包括手部自由度高、运动学结构复杂、自遮挡和结构自相似带来的感知模糊,以及传感器噪点和深度不连续等数据退化问题。
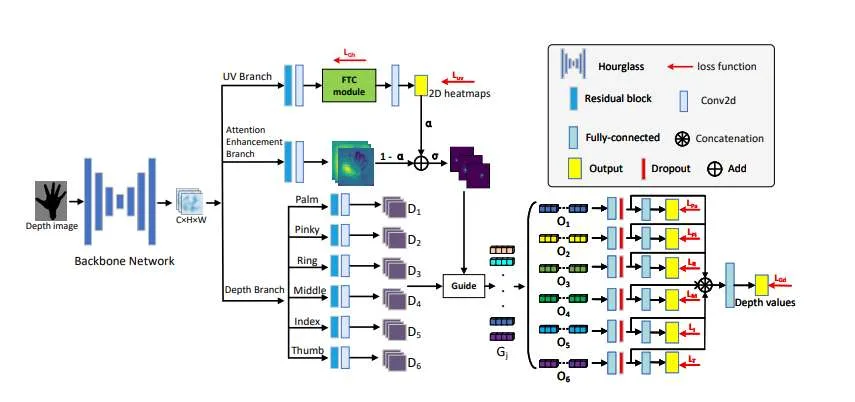
在方法上,KAD-Net采用两个分支分别估计UV坐标和深度值,以减少任务级干扰。UV分支中引入手指拓扑约束(FTC)模块。该模块通过节点映射、图空间消息传递和节点重映射,利用三个连续手指关节构建局部运动学表示,对远端关节特征进行补充和约束。研究人员指出,这种设计还能利用同一运动链上可见关节的结构线索,帮助定位部分或完全被遮挡的远端关节。
深度分支采用层次化多任务结构。团队设置了一个不施加损失监督的注意力增强分支,该分支生成的注意力图与UV分支的运动学感知热图融合,用于突出对手部深度估计关键的区域。深度分支将任务分解为六个并行子任务,分别对应五个手指和手掌,并估计局部深度值和全局深度值。研究人员认为,深度回归比2D定位更难,因此需要专门的多任务学习策略来减少负面特征迁移。
他们在ICVL、NYU和MSRA数据集上评估了KAD-Net。报告称,该模型在三个数据集上的平均关节误差(MJE)分别为5.45毫米、7.43毫米和6.93毫米。在ICVL数据集上,对比方法包括DeepPrior++、REN-9×6×6、DenseReg、CrossInfoNet、NARHT、A2J、V2V-PoseNet、SRNet、JGR-P2O、AWR、HandFoldingNet和TriHorn-Net等。KAD-Net在ICVL上取得5.45毫米的MJE,优于这些对比方法;在NYU上除手掌外,其余关节表现优于对比的当前最优方法;在MSRA上也在多数视角变化下降低了误差。
团队同时给出消融实验结果。在ICVL上,基线模型MJE为5.73毫米,加入FTC模块后为5.63毫米,加入深度方向层次化多任务架构(MMD)后为5.61毫米,两者同时加入后为5.45毫米。多任务架构对比中,共享架构MJE为6.68毫米,解耦架构为5.64毫米,引导解耦架构为5.61毫米。这些结果说明FTC模块和MMD架构具有互补作用,解耦并引入UV空间指导有助于改善深度估计。
在效率方面,KAD-Net在ICVL上的MJE为5.45毫米,参数数量为11.98M,推理速度为87 FPS。该模型在保持实时速度的同时取得了较低误差,并维持了适中的参数规模。
当然,团队提到了局限性。当手部大部分被严重遮挡时会出现失败案例。由于模型依赖相关关节信息来保持结构一致性,当多个关节同时出现较大初始估计误差或较高不确定性时,性能可能下降。